ML-LAB
1. Implement and demonstrate the FIND-S algorithm for finding the mostspecific hypothesis based on a given set.
import csv

h = ['0'] * 6
for row in csv.reader(open('tennis.csv')):
    print(row)
    if row[-1] == "True":
        h = [x if g in ('0', x) else '?' for g, x in zip(h, row[:-1])]

print("Most specific hypothesis is\n", h)
['Sunny', 'Warm', 'Normal', 'Strong', 'Warm', 'Same', 'True']
['Sunny', 'Warm', 'High', 'Strong', 'Warm', 'Same', 'True']
['Rainy', 'Cold', 'High', 'Strong', 'Warm', 'Change', 'False']
['Sunny', 'Warm', 'High', 'Strong', 'Cool', 'Change', 'True']
Most specific hypothesis is
['Sunny', 'Warm', '?', 'Strong', '?', '?']2. Build and test an Artificial Neural Network by implementing the Back propagation algorithm
pip install sklearnpip install numpyimport numpy as np
from sklearn.neural_network import MLPRegressor
X = np.array([[2, 9], [1, 5], [3, 6]]) / [3, 9]
y = np.array([92, 86, 89]) / 100
model = MLPRegressor(hidden_layer_sizes=(3,), activation='logistic', solver='sgd',
learning_rate_init=0.1, max_iter=7000).fit(X, y)
print("Input:\n", X, "\nActual Output:\n", y, "\nPredicted Output:\n", model.predict(X))Input:
[[0.66666667 1. ]
[0.33333333 0.55555556]
[1. 0.66666667]]
Actual Output:
[0.92 0.86 0.89]
Predicted Output:
[0.95169644 0.91245618 0.95456524]3. Assuming a set of documents that need to be classified, use the naiveBayesianClassifiermodel to perform this task
pip install pandas sklearnimport pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn import metrics
msg = pd.read_csv('naivetext1.csv', names=['message', 'label'])
xtrain, xtest, ytrain, ytest = train_test_split(msg.message, msg.label.map({'pos': 1, 'neg': 0}))
model = make_pipeline(CountVectorizer(), MultinomialNB()).fit(xtrain, ytrain)
pred = model.predict(xtest)
print('Accuracy:', metrics.accuracy_score(ytest, pred))
print('Confusion matrix:\n', metrics.confusion_matrix(ytest, pred))
print('Recall:', metrics.recall_score(ytest, pred), '\nPrecision:', metrics.precision_score(ytest, pred))Accuracy: 0.6
Confusion matrix:
[[2 1]
[1 1]]
Recall: 0.5
Precision: 0.54. construct a Bayesian network considering medical data
pip install pgmpy
from pgmpy.models import DiscreteBayesianNetwork
from pgmpy.factors.discrete import TabularCPD
from pgmpy.inference import VariableElimination

s = ['True', 'False']
net = DiscreteBayesianNetwork([('asia', 'tuberculosis')])
net.add_node('smoking')
net.add_cpds(
    TabularCPD('asia', 2, [[0.5], [0.5]], state_names={'asia': s}),
    TabularCPD('smoking', 2, [[0.5], [0.5]], state_names={'smoking': s}),
    TabularCPD('tuberculosis', 2, [[0.2, 0.01], [0.8, 0.99]], evidence=['asia'],
               evidence_card=[2], state_names={'tuberculosis': s, 'asia': s}))

infer = VariableElimination(net)
for v in ['asia', 'smoking']:
    print(infer.query([v], evidence={'tuberculosis': 'True'}))
asia(True)     0.9524
asia(False)    0.0476

smoking(True)  0.5000
smoking(False) 0.5000
pip install pgmpyfrom pgmpy.models import DiscreteBayesianNetwork
from pgmpy.factors.discrete import TabularCPD
from pgmpy.inference import VariableElimination
s = ['True', 'False']
net = DiscreteBayesianNetwork([('asia', 'tuberculosis')])
net.add_node('smoking')
net.add_cpds(
TabularCPD('asia', 2, [[0.5], [0.5]], state_names={'asia': s}),
TabularCPD('smoking', 2, [[0.5], [0.5]], state_names={'smoking': s}),
TabularCPD('tuberculosis', 2, [[0.2, 0.01], [0.8, 0.99]], evidence=['asia'],
evidence_card=[2], state_names={'tuberculosis': s, 'asia': s}))
infer = VariableElimination(net)
for v in ['asia', 'smoking']:
print(infer.query([v], evidence={'tuberculosis': 'True'}))asia(True) 0.9524
asia(False) 0.0476
smoking(True) 0.5000
smoking(False) 0.50005. implement k-Nearest Neighbour algorithm to classify the iris dataset.
pip install numpy sklearn
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
data = pd.read_csv('knndat.data', header=None)
xtrain, xtest, ytrain, ytest = train_test_split(data.iloc[:, :4], data.iloc[:, -1], train_size=0.67)
model = KNeighborsClassifier(n_neighbors=3).fit(xtrain, ytrain)
print('Train set:', len(xtrain), '\nTest set:', len(xtest))
for p, a in zip(model.predict(xtest), ytest):
    print(f'> predicted={p!r}, actual={a!r}')
print('Accuracy:', model.score(xtest, ytest) * 100, '%')
Train set: 100
Test set: 50
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-versicolor', actual='Iris-versicolor'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-setosa', actual='Iris-setosa'
> predicted='Iris-virginica', actual='Iris-virginica'
> predicted='Iris-virginica', actual='Iris-virginica'
Accuracy: 98.0 %
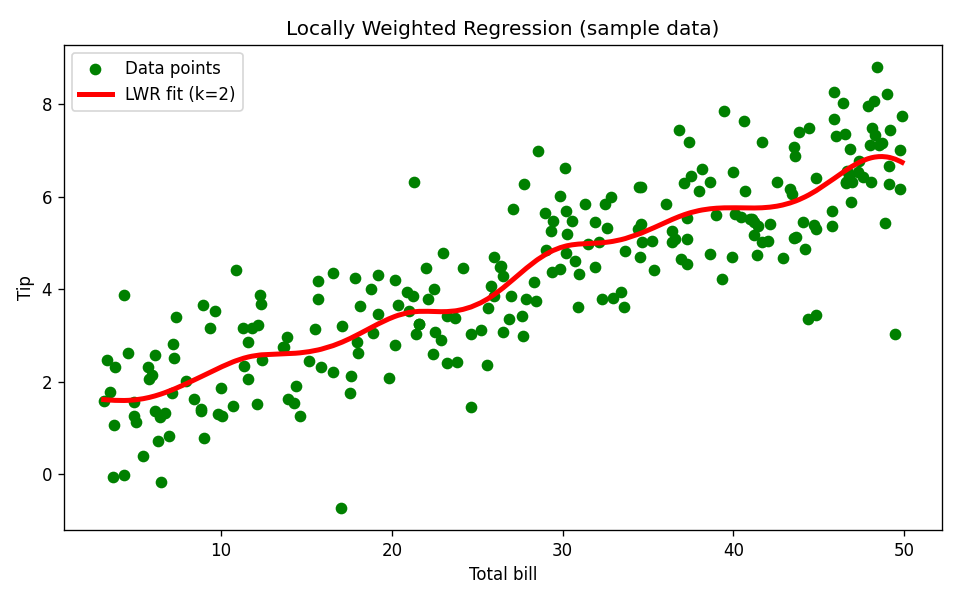
6. Implement the non-parametric Locally Weighted Regressionalgorithm in order to fit data points.
pip install numpy pandas matplotlibimport numpy as np, pandas as pd
import matplotlib.pyplot as plt
data = pd.read_csv('data10.csv')
x, y = data.total_bill.values, data.tip.values
X = np.c_[np.ones(len(x)), x]
def lwr(x0, k=2):
w = np.exp(-(x - x0) ** 2 / (2 * k ** 2))
theta = np.linalg.pinv(X.T @ (w[:, None] * X)) @ X.T @ (w * y)
return theta[0] + theta[1] * x0
ypred = np.array([lwr(v) for v in x])
i = x.argsort()
plt.scatter(x, y, color='green')
plt.plot(x[i], ypred[i], color='red', linewidth=3)
plt.xlabel('Total bill'); plt.ylabel('Tip'); plt.show()